Synchronizacja modelu ról między środowiskami: jak pozbyliśmy się "działa tylko na prodzie"
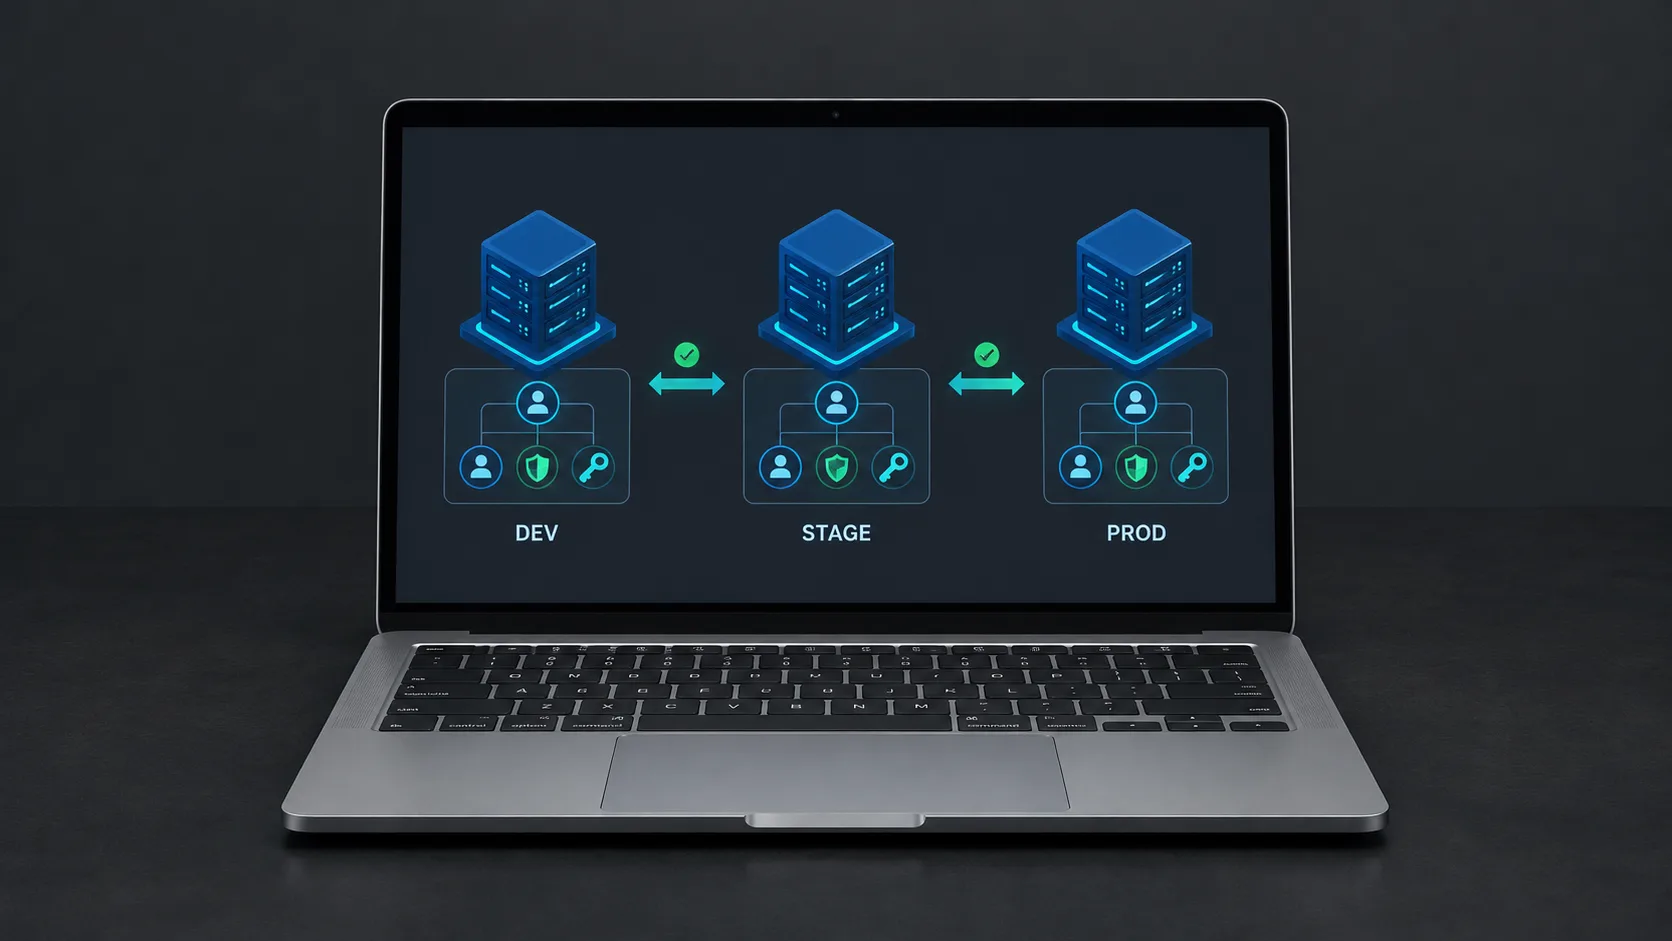
Wsparcie i menedżerowie zarządzali modelem ról tylko na produkcji, przez co test i preprod miały niepełne dane, a części scenariuszy nie dało się odtworzyć. Wdrożyliśmy jednokierunkową synchronizację z produkcji: dodawanie i usuwanie encji, flagi pomijania, dopasowanie po slugu oraz uruchamianie przez cron lub przycisk w panelu. Model ról jest teraz **spójny** między środowiskami.
Problem: „Działa tylko na produkcji”
Przypomnijmy kontekst. W artykule o modelu ról opisywaliśmy, jak wdrożyliśmy elastyczny system kontroli dostępu: rola + organizacja + uprawnienia niestandardowe, macierz uprawnień, interfejs zarządzania i historia zmian.
System ten miał jednak pewną cechę, która z czasem stała się problemem.
Jak to działało?
W projekcie były trzy środowiska: testowe, przedprodukcyjne i produkcyjne.
Zespół wsparcia i menedżerowie zarządzali modelem ról wyłącznie na produkcji.
Środowiska testowe i przedprodukcyjne otrzymywały niepełny model ról — aktualizowany dopiero po wprowadzeniu zmian na produkcji.
Co to oznaczało w praktyce?
- Niektórych scenariuszy z produkcji nie dało się odtworzyć w środowisku testowym ani przedprodukcyjnym.
- Przyczyną były różnice między środowiskami: dane produkcyjne różniły się od danych testowych.
- Testowanie modelu ról zamieniało się w loterię: „A jak to właściwie wygląda na produkcji?”.
Klasyczna sytuacja: „U mnie lokalnie działa, a na produkcji nie”. Tyle że w skali modelu ról całego projektu.
Rozwiązanie: synchronizacja modelu ról
Przeanalizowaliśmy problem i zbudowaliśmy system synchronizacji. Oto jego najważniejsze elementy.
1. Synchronizujemy zarówno dodawanie, jak i usuwanie
Synchronizacja powinna odzwierciedlać pełny stan modelu ról: jeśli na produkcji dodano rolę, pojawia się ona również w środowisku testowym i przedprodukcyjnym. Jeśli została usunięta — znika także z tych środowisk.
To ważne, ponieważ w przeciwnym razie w środowiskach gromadzą się zbędne encje, które nie istnieją już na produkcji.
2. Flagi pomijania dla ról, uprawnień i grup
Dla ról, uprawnień i grup dodaliśmy flagę pozwalającą wyłączyć je z synchronizacji — zarówno przy dodawaniu, jak i usuwaniu.
Po co?
- Aby nie usuwać potrzebnych encji podczas synchronizacji. Na przykład w środowisku testowym może istnieć encja potrzebna do testów, której nie ma na produkcji. Flaga pomijania chroni ją przed usunięciem.
- Aby nie dodawać zbędnych encji. Jeśli encja jest oznaczona jako pomijana, nie zostanie zsynchronizowana.
To elastyczny mechanizm: pozwala precyzyjnie określać, co podlega synchronizacji, a co pozostaje lokalną specyfiką danego środowiska.
3. Środowiska testowe i przedprodukcyjne synchronizują się wyłącznie z produkcją
Synchronizacja jest jednokierunkowa: z produkcji do środowisk testowego i przedprodukcyjnego. Produkcja nie może pobierać zmian z innego środowiska w ramach synchronizacji.
Dlaczego?
- Produkcja stanowi źródło prawdy dla modelu ról.
- Środowiska testowe i przedprodukcyjne są odbiorcami.
- Synchronizacja w przeciwnym kierunku — z testów na produkcję — stwarzałaby ryzyko przeniesienia zmian testowych do środowiska produkcyjnego.
4. Synchronizacja: cron i przycisk w panelu administracyjnym
Zaimplementowaliśmy dwa sposoby uruchamiania synchronizacji:
- Automatycznie w tle, zgodnie z harmonogramem: cron i Laravel Scheduler. Synchronizacja uruchamia się co godzinę w godzinach pracy — od 09:00 do 18:00.
- Ręcznie, przyciskiem w panelu administracyjnym: przycisk jest dostępny wyłącznie w środowiskach testowym i przedprodukcyjnym, a jego dostępność jest sterowana konfiguracją.
Dlaczego oba sposoby?
Cron zapewnia regularną synchronizację bez udziału człowieka.
Przycisk przydaje się wtedy, gdy synchronizację trzeba wykonać „tu i teraz”, na przykład po pilnej zmianie na produkcji.
5. Dopasowywanie danych na podstawie sluga
Dane są dopasowywane na podstawie sluga, a nie UUID.
Dlaczego?
UUID jest unikalny, ale nie służył nam jako klucz do wyszukiwania odpowiadających sobie rekordów w różnych środowiskach.
Slug to czytelny dla człowieka identyfikator, który pozwala dopasowywać encje między środowiskami.
6. Ochrona API: lista dozwolonych adresów IP i uprawnienia użytkownika API
Endpoint API na produkcji był dostępny wyłącznie dla adresów IP z listy dozwolonych. Dodatkowo sprawdzano uprawnienia użytkownika API: nie każdy użytkownik API miał dostęp do tego endpointu.
Po co?
- Lista dozwolonych adresów IP chroni przed nieautoryzowanymi wywołaniami z zewnątrz.
- Uprawnienia użytkownika API zapewniają dodatkową warstwę kontroli: tylko upoważnieni użytkownicy mogą pobierać dane modelu ról.
7. Osobni użytkownicy dla testów i produkcji oraz tokeny Bearer
Dla środowiska testowego i produkcyjnego utworzyliśmy osobnych użytkowników, uwierzytelnianych za pomocą tokenów Bearer ważnych przez 24 godziny.
Dlaczego?
Osobni użytkownicy zapewniają izolację: przejęcie tokenu użytkownika testowego nie oznacza przejęcia danych uwierzytelniających użytkownika produkcyjnego.
Token Bearer ważny przez 24 godziny to kompromis między bezpieczeństwem a wygodą: nie trzeba ponawiać logowania przy każdym żądaniu, a token automatycznie wygasa.
Jak to działa: pełny cykl synchronizacji
Proces synchronizacji wygląda następująco:
- Członek zespołu wsparcia lub menedżer dodaje na produkcji nową rolę, uprawnienie albo grupę.
- Cron lub przycisk w panelu administracyjnym uruchamia synchronizację w środowiskach testowym i przedprodukcyjnym.
- Do produkcyjnego API trafia żądanie z tokenem Bearer, wysłane z adresu IP znajdującego się na liście dozwolonych.
- API produkcyjne sprawdza uprawnienia użytkownika API i zwraca dane modelu ról.
- Środowiska testowe i przedprodukcyjne dopasowują dane na podstawie slugów, ustalając, co należy dodać, a co usunąć.
- Uwzględniane są flagi pomijania — oznaczone nimi encje nie podlegają synchronizacji.
- Zmiany zostają zastosowane, a model ról w środowiskach testowym i przedprodukcyjnym zostaje zaktualizowany.
Rezultat: synchronizacja działa
Zaimplementowaliśmy wszystkie opisane elementy, a synchronizacja encji modelu ról między środowiskami działa poprawnie.
Stos technologiczny
- Backend: Laravel (PHP)
- Harmonogram: cron + Laravel Scheduler
- API: tokeny Bearer i lista dozwolonych adresów IP
- Dopasowywanie danych: na podstawie slugów
Wnioski z tego projektu
1. Środowiska muszą być porównywalne
Jeśli środowiska testowe i przedprodukcyjne nie odzwierciedlają produkcji, testowanie traci sens. Synchronizacja modelu ról sprawiła, że środowiska stały się porównywalne.
2. Synchronizacja jednokierunkowa jest bezpieczniejsza
Synchronizacja wyłącznie z produkcji do środowisk testowego i przedprodukcyjnego eliminuje ryzyko przeniesienia zmian testowych na produkcję za pośrednictwem tego mechanizmu.
3. Flagi pomijania zapewniają elastyczność bez chaosu
Nie wszystko musi być synchronizowane. Flagi pomijania pozwalają zachować lokalną specyfikę środowisk bez naruszania spójności całego modelu.
4. Bezpieczeństwo API jest niezbędne
Lista dozwolonych adresów IP i tokeny Bearer o ograniczonym czasie ważności to podstawowe zabezpieczenia API udostępniającego dane modelu ról.
Podsumowanie
Ta historia pokazuje, że model ról to nie tylko interfejs i macierz uprawnień. To również infrastruktura: synchronizacja między środowiskami, ochrona API i mechanizmy dopasowywania danych.
Zbudowaliśmy system, który uwolnił zespół od problemu „działa tylko na produkcji”. Teraz środowiska testowe i przedprodukcyjne odzwierciedlają rzeczywisty model ról, a testowanie stało się przewidywalne.